Kapag gumagamit ng mga ahente, kailangan ng mga developer ang parehong pagpipilian at kontrol. Kailangan nila ng mga teknolohiyang nag-aalok ng malinaw na mga hangganan para sa kanilang mga ahente at ginagawang madali ang pagpili ng modelo na may tamang bilis, pagganap, at profile ng gastos para sa bawat gawain. Iyon ang dahilan kung bakit nag-aalok ang GitHub ng mga frontier na modelo mula sa mga pangunahing provider ng modelo, pati na rin ang mga opsyon tulad ng Project HydraFusion, isang orchestrator na pumipili ng isa o maraming modelo para sa bawat gawain habang binabalanse ang performance, gastos, at latency. Ito rin ang dahilan kung bakit binuo ng Windows ang Microsoft Execution Containers (MXC) upang tumulong sa pag-secure ng mga interactive at non-interactive na agentic coding session.
Pagdating sa katapusan ng buwan, tutukuyin ng GitHub Copilot kung kailan pinakamahusay na mapangasiwaan ang isang gawain ng on-device intelligence at kung kailan ito dapat gumamit ng mga cloud-scale na modelo. Sa halip na pilitin ang mga developer na pamahalaan ang kanilang mga desisyon sa imprastraktura, ang GitHub Copilot ay awtomatikong nagkoordina ng lokal at cloud inference sa likod ng mga eksena. Para sa mga NVIDIA RTX Spark Windows PC tulad ng Surface Laptop Ultra, nangangahulugan iyon na pinapagana namin ang lokal na coding sa GitHub Copilot na may makapangyarihang mga modelo ng lokal na hinuha at hardware na may kakayahang maghatid ng magandang karanasan sa dulo.
Ang resulta ay nakahanda na maging susunod na hakbang sa HydraFusion vision: matalinong orkestrasyon na sumasaklaw hindi lamang sa maraming modelo, ngunit sa maraming compute environment kabilang ang gilid. Maaaring magpatakbo ang GitHub Copilot ng mga command sa mga environment na ito na may kontroladong access sa mga file, network, kakayahan ng system, at mga kredensyal. Maaaring mag-automate ang mga developer nang may kumpiyansa at seguridad sa isip.
Bakit mahalaga ang memorya para sa isang lokal na ahente ng coding
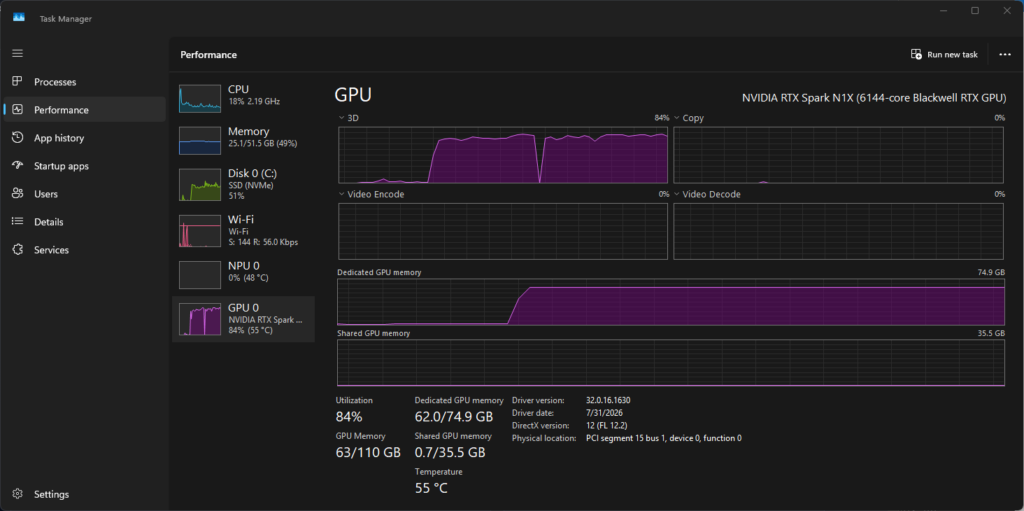
Ang lokal na hinuha ay nagsisimula sa isang badyet ng memorya. Ang Surface Laptop Ultra ay binuo sa paligid ng NVIDIA RTX Spark, na may hanggang 128 GB ng pinag-isang memorya at hanggang 1 petaflop ng AI compute.
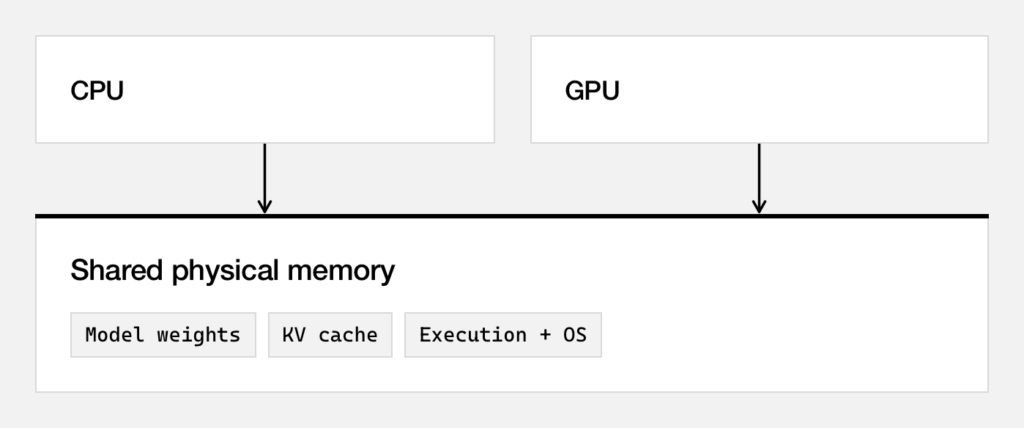
Sa isang discrete GPU, ang nakatuong memory ng video ay isang mahalagang hadlang: ang paglipat ng data ng modelo sa pagitan ng memorya ng system at ang GPU ay maaaring magdagdag ng overhead. Ang pinag-isang memorya ay nagbibigay sa CPU at GPU ng access sa isang nakabahaging pisikal na pool. Ginagawa nitong mas maraming kapasidad ang magagamit sa workload, ngunit hindi nito ginagawang available ang lahat sa mga timbang ng modelo.
Ang operating system, ang iyong mga application, at ang inference runtime ay nangangailangan din ng memorya. Gayundin ang key-value cache, na nag-iimbak ng estado ng atensyon para sa mga token na naproseso na ng modelo. Habang binabasa ng isang ahente ang mga file at tumatanggap ng mga resulta ng tool, maaaring lumaki ang konteksto nito, tumataas ang paggamit ng memorya at ang gawaing kailangan upang maproseso ang susunod na kahilingan.
Ang pagpapanatiling naka-load ang isang modelo sa pagitan ng mga kahilingan ay maaaring maiwasan ang paulit-ulit na pag-load. Gayunpaman, hindi nito ginagarantiyahan ang patuloy na oras ng pagtugon; mahalaga pa rin ang haba ng konteksto, presyon ng memorya, at ang iba pang workload. Iyon ang dahilan kung bakit ang kapaki-pakinabang na tanong ay hindi lamang kung ang isang modelo ay umaangkop, ngunit kung paano ito kumikilos sa isang kumpletong gawain sa pag-coding.
Ipinapakilala ang MAI Code 1.1 Flash para sa lokal na coding
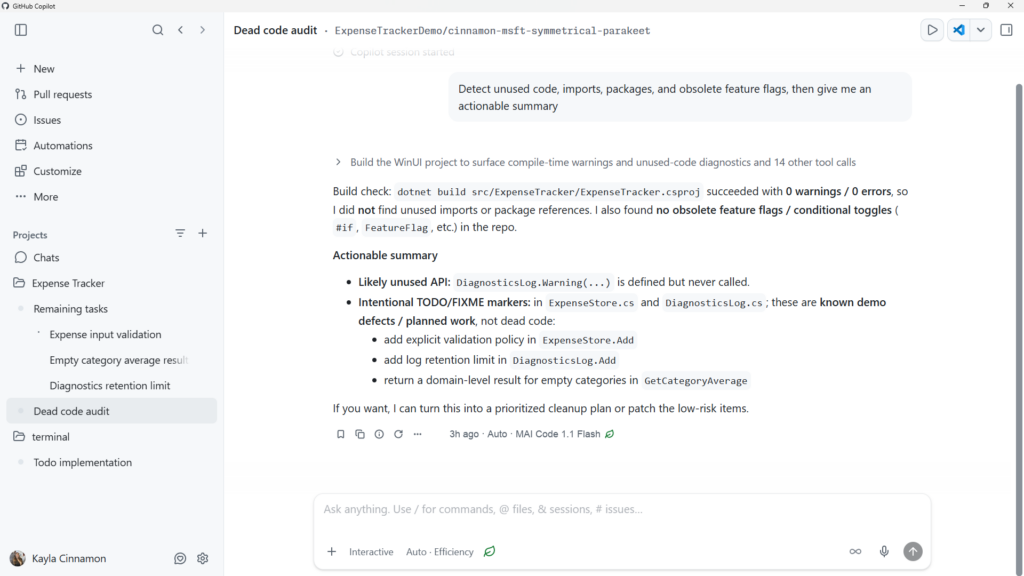
Upang bigyang-buhay ang karanasang ito sa local-development, binuo ng Microsoft AI ang isang lokal na bersyon ng MAI Code 1.1 Flash, isang coding-optimized mixture-of-experts model na may kabuuang 137 bilyon at 6.8 bilyong aktibong parameter. Inilalapat ng on-device na gawain ang quantization at speculative decoding para bawasan ang footprint ng modelo at pahusayin ang end-to-end na pagtugon habang pinapanatili ang pagkumpleto ng gawain at kalidad ng paggamit ng tool na mahalaga sa isang loop ng ahente.
Binabawasan ng quantization ang katumpakan na ginamit upang kumatawan sa mga timbang at pag-activate ng modelo, na nagpapababa ng mga kinakailangan sa memorya. Dahil hindi maganda ang pagbaba ng code, dapat masukat ng pagsusuri sa release ang tagumpay ng coding-task pati na rin ang footprint: ang isang maling token ay maaaring magdulot ng error sa syntax, maling identifier, malformed tool call, o sirang diff.
Ang speculative decoding ay nakikipagkalakalan ng karagdagang working memory para sa mas mataas na decode throughput at mas mababang end-to-end latency. Ang isang drafter ay nagmumungkahi ng mga bloke ng token ng kandidato at bini-verify ng target na modelo ang mga ito.
Para sa isang coding agent, ang mahalagang tradeoff ay kung ang mas maliit na modelo ay maaari pa ring kumpletuhin ang parehong mga gawain. Ang isang mas maliit na footprint ay kapaki-pakinabang lamang kung ang mga pagbabago sa kalidad ng code at paggamit ng tool ay nauunawaan.
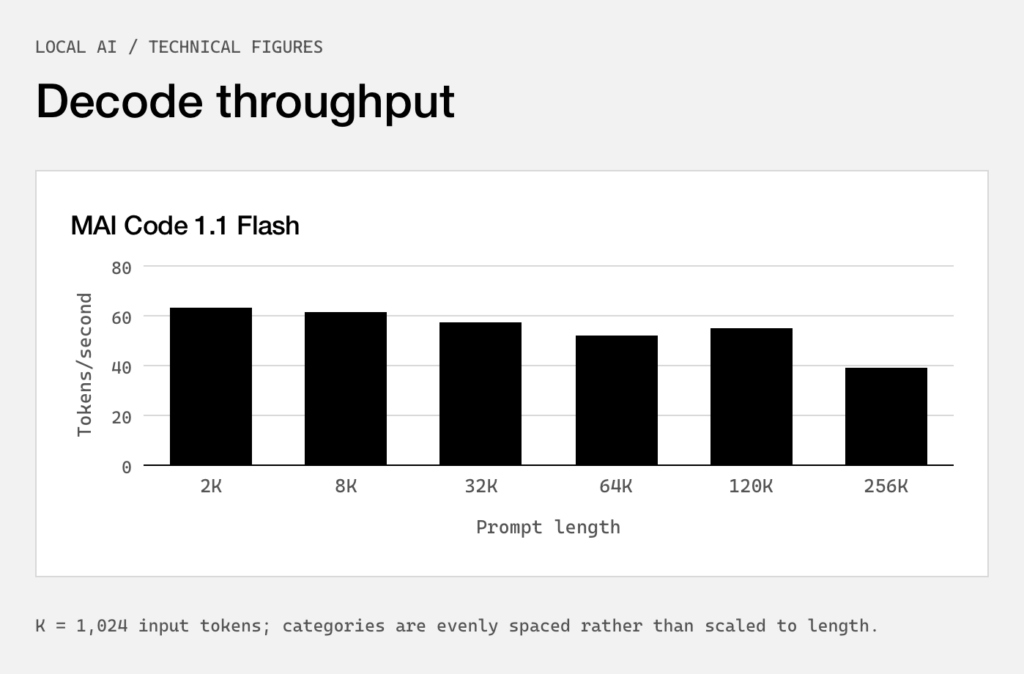
Sa aming unang bersyon ng pagpapadala ng MAI Code 1.1 Flash sa Surface Laptop Ultra, nakakamit namin ang sumusunod na performance sa iba’t ibang haba ng konteksto, na may pinakamataas na paggamit ng memory na 75.5GB sa 256k na konteksto. Sa 64k at 128k na konteksto, ang prompt-processing throughput ay umaabot sa 923.5 at 769.8 token bawat segundo, ayon sa pagkakabanggit.
Ang quantized na bersyon ng MAI Code 1.1 Flash na ginagamit namin sa device ay nagpapanatili ng kahanga-hangang kakayahan kumpara sa Bfloat16 cloud variant, na umaabot sa 53GB, isang 80% na pagbawas sa laki.
| Benchmark | Laki ng dataset | MAI Code 1.1 Flash | GPT OSS 120B* | MAI Code 1.1 Flash Quantized sa Device |
|---|---|---|---|---|
| Na-verify ang SWE-Bench | 500 | 72.6% | 32.0% | 70.80% |
| Terminal-Bench 2.1 | 89 | 62.9% | 23.6% | 66.29% |
Sinubukan noong Oktubre 5, 2026 gamit ang MAI Code 1.1 Flash (mixed-precision quantization, humigit-kumulang 3.3 bits bawat timbang) gamit ang DFlash2 sliding-window speculative decoding at isang Windows ARM64 llama.cpp CUDA runtime. Ang mga resulta ay sumasalamin sa pag-decode ng throughput para sa isang synthetic na code-generation workload; maaaring mag-iba ang aktwal na mga resulta ayon sa device, configuration, at iba pang salik.
Dalawang paraan upang magamit ang mga lokal na modelo sa GitHub Copilot
Ang GitHub Copilot ay nagdaragdag ng dalawang paraan upang magamit ang mga lokal na modelo sa buong GitHub Copilot CLI, Copilot app, at VS Code. Maaaring hayaan ng mga developer ang intelligent Auto orchestration ng Copilot na pumili kung kailan gagamit ng lokal o cloud inference, o maaari silang tahasang pumili ng lokal na modelo para sa mga workflow na nangangailangan ng direktang kontrol.
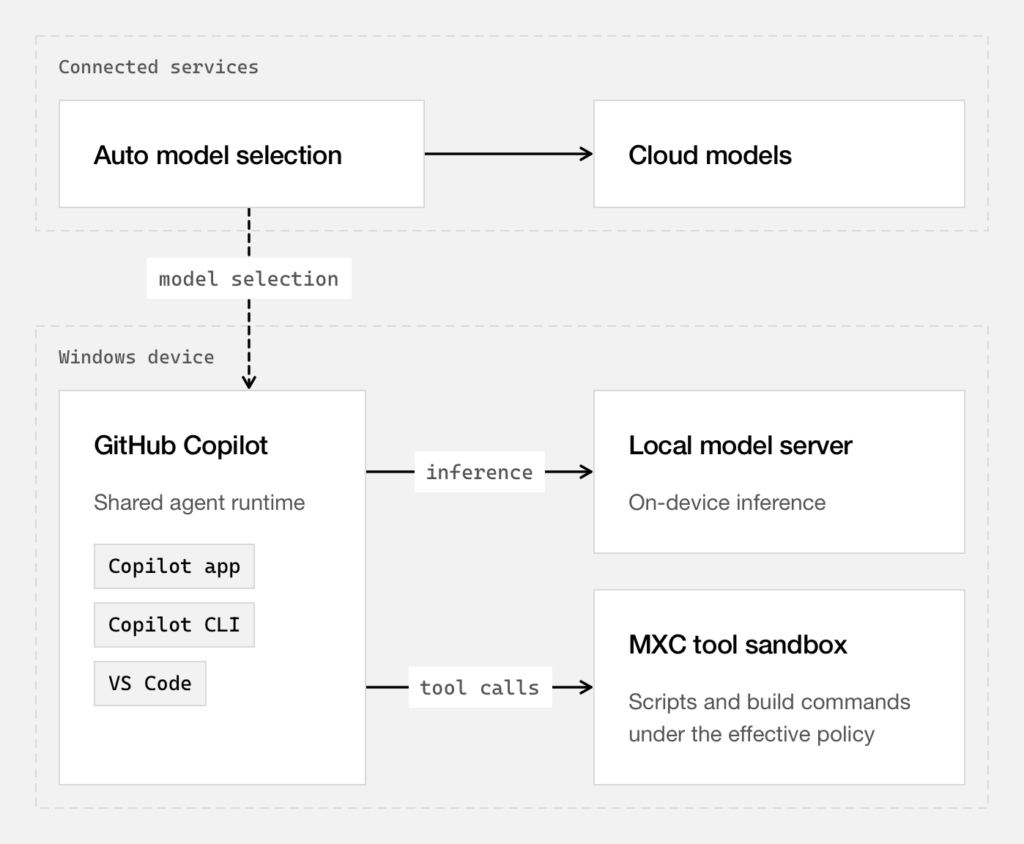
Sa Auto, hindi kailangang magpasya ng mga developer kung saan dapat patakbuhin ang bawat gawain. Sa kabuuan ng isang multi-turn session, maaaring isaalang-alang ng Copilot ang konteksto ng gawain at katayuan ng cache habang dinadala nito ang trabaho sa pagitan ng mga lokal at cloud na modelo, na pinapanatili ang kapaki-pakinabang, naka-cache na trabaho habang nagbabago ang session.
Ang nakaayos na karanasang ito ay umaakma sa direktang pagpili ng modelo, na nagbibigay sa mga developer ng pagpipilian sa pagitan ng pagpapahintulot sa Copilot na i-optimize ang paglalagay ng modelo at ang pagpili ng isang partikular na lokal na modelo mismo.
Ang tahasang pagpili ng lokal na modelo ay sumusuporta sa mga workflow na nangangailangan ng partikular na provider, modelo, o endpoint. Maaaring piliin ng mga developer ang MAI Code 1.1 Flash sa pamamagitan ng provider ng Windows ML o ikonekta ang GitHub Copilot sa mga lokal na endpoint na tugma sa OpenAI at pumili mula sa mga modelong inilalantad ng mga endpoint na iyon.
Paano nakakatulong ang mga sandbox sa secure na tool execution
Ang mga shell command ng ahente ay karaniwang namamana ng access ng account na nagpapatakbo sa kanila. Ang paglipat ng hinuha sa device ay hindi nagbabago. Naglalapat ang Sandboxing ng patakaran sa mga proseso at lokal na serbisyong inilulunsad ng ahente, kinokontrol ang pag-access sa mga file, network, kredensyal, kakayahan ng system, at mga landas ng pagpapatupad anuman ang modelong humiling ng trabaho.
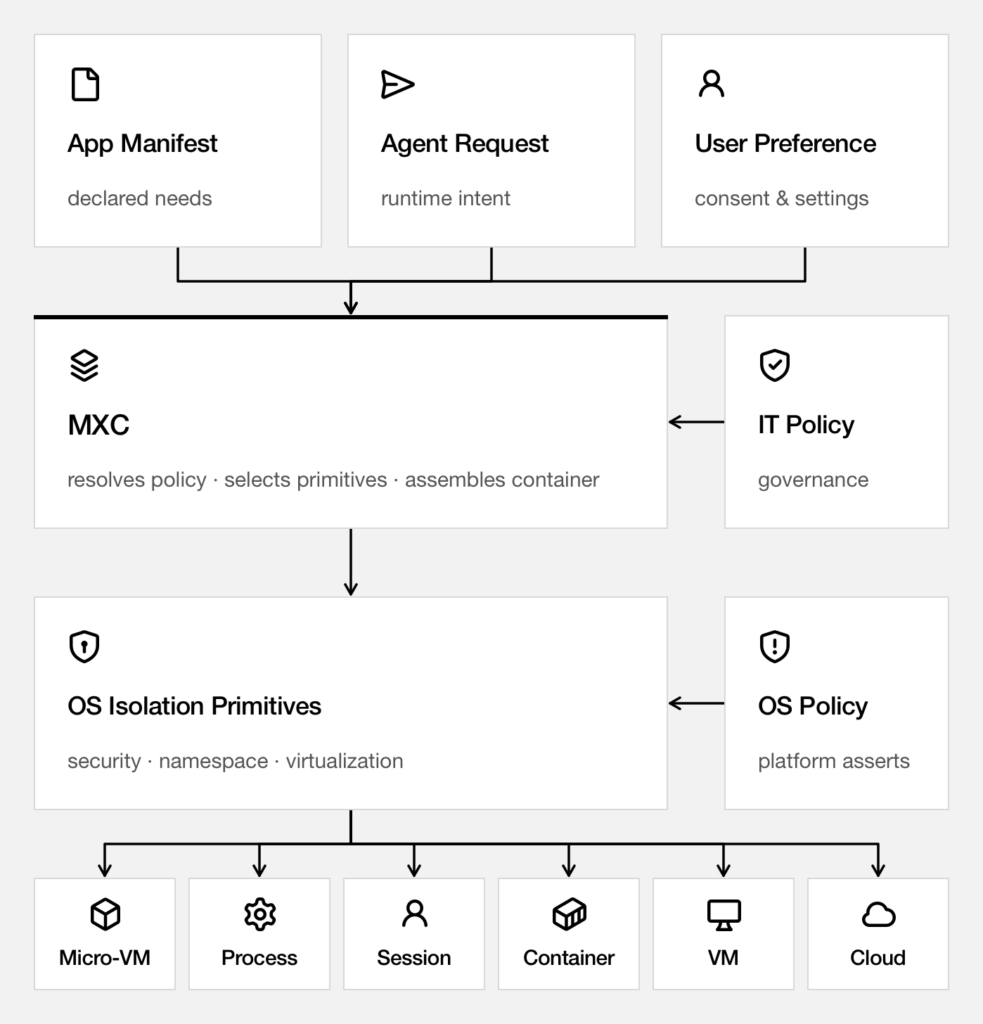
Gumagamit ang GitHub Copilot ng Microsoft Execution Containers, o MXC, isang open-source na library mula sa Windows team na nagsasalin ng patakaran sa mga native na kontrol sa operating system. Sa Windows, ginagamit ng GitHub Copilot ang BaseContainer tier ng ProcessContainer backend. Sa macOS, gumagamit ito ng Seatbelt. Sa Linux, gumagamit ito ng bubblewrap. Ang mga lokal na backend na ito ay hindi nangangailangan ng hiwalay na virtual machine o container na imahe, ngunit plano naming gawing available ang mga ito sa pamamagitan ng MXC sa hinaharap.
Kapag pinagana ang sandboxing, ang mga shell command at, bilang default, ang mga lokal na Model Context Protocol server at mga server ng wika ay tumatakbo sa loob ng hangganan ng proseso. Ang mga built-in na tool sa file ay tumatakbo sa loob mismo ng GitHub Copilot: sinusuri ng ahente ang kanilang mga kahilingan laban sa epektibong patakaran, ngunit ang mga pagsusuring iyon ay hindi ipinapatupad ng OS na paghihiwalay sa proseso ng bata. Ang mga remote MCP server ay nasa labas din ng lokal na proseso ng sandbox; kapag nalalapat ang mga kontrol sa sandbox ng MCP, sinusuri ng GitHub Copilot ang kanilang patakaran sa koneksyon sa proseso.
Binibigyang-daan ka ng pagbubukas ng GitHub Copilot CLI at pagpapatakbo ng `/sandbox` slash command na i-configure ang iyong mga setting anumang oras.
Isang halimbawa sa totoong mundo: Pang-araw-araw na dashboard ng repository
Upang ipakita kung paano gumagana ang mga teknolohiyang ito nang magkakasama, gumamit tayo ng isang tunay na halimbawa sa mundo.
Isaalang-alang ang isang trabaho na nagbabasa ng mga lokal na repositoryo, nagpapatakbo ng kanilang mga pagsubok sa mga gumaganang kopya, at nagsusulat ng isang ulat sa HTML tuwing umaga. Dapat manatiling read-only ang mga source repository, at hindi dapat ma-access ng mga proseso ng pagsubok ang network. Ang pagpili ng modelo ay independyente: ang parehong trabaho ay maaaring gumamit ng naka-configure na lokal o cloud na modelo.
Paganahin ang sandboxing para sa iyong proyekto
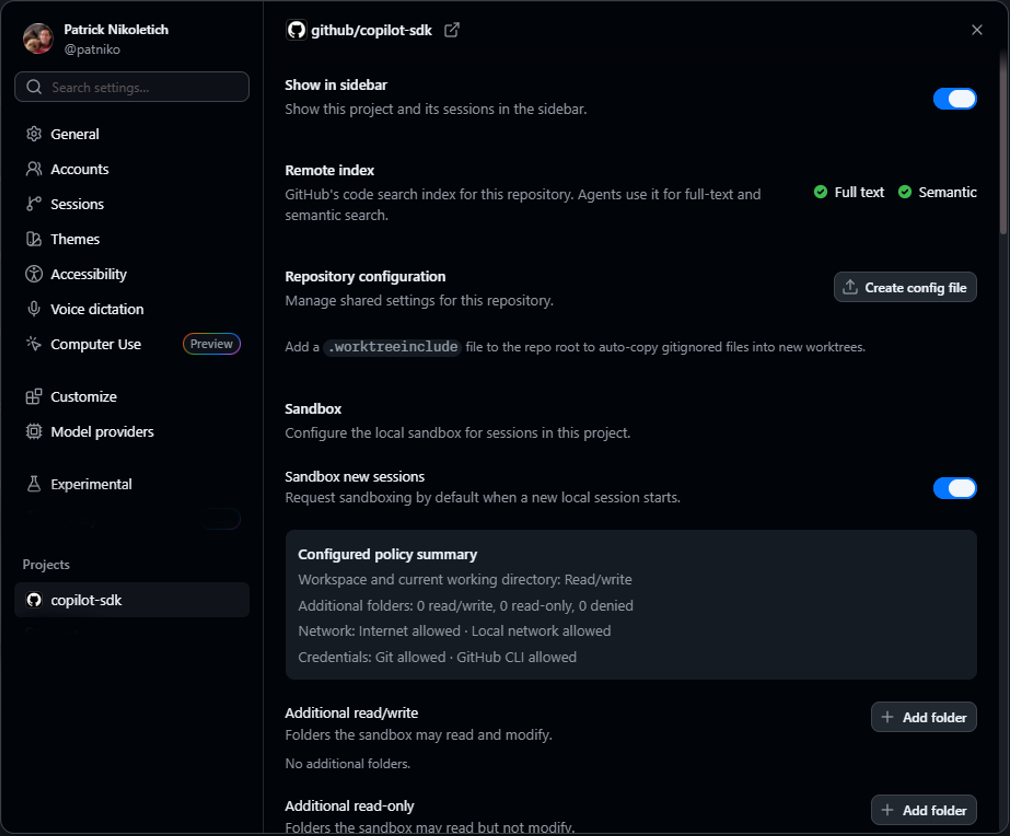
Buksan ang dialog ng mga setting sa pamamagitan ng pag-click sa icon na gear sa GitHub Copilot app at pagpili sa iyong proyekto sa kaliwang menu. Para sa halimbawang ito, gagamitin namin ang repo na `copilot-sdk` na nagho-host sa aming opensource na GitHub Copilot Runtime/SDK na proyekto.
Ang pag-enable sa toggle ng `Sandbox new sessions` ay mag-o-on sa sandboxing bilang default sa tuwing nagtatrabaho ka sa loob ng proyektong iyon. Bilang default, ito ay kasalukuyang gumagana nang direkta ay read/write habang ang natitirang bahagi ng system ay nananatiling higit na read-only o hindi naa-access sa isang ahente.
Gumawa ng bagong automation
Piliin ang seksyong` Automations` sa kaliwang nabigasyon at i-click ang button na `Start automation` upang buksan ang dialog na nagbibigay-daan sa iyong mag-configure ng bagong automation.
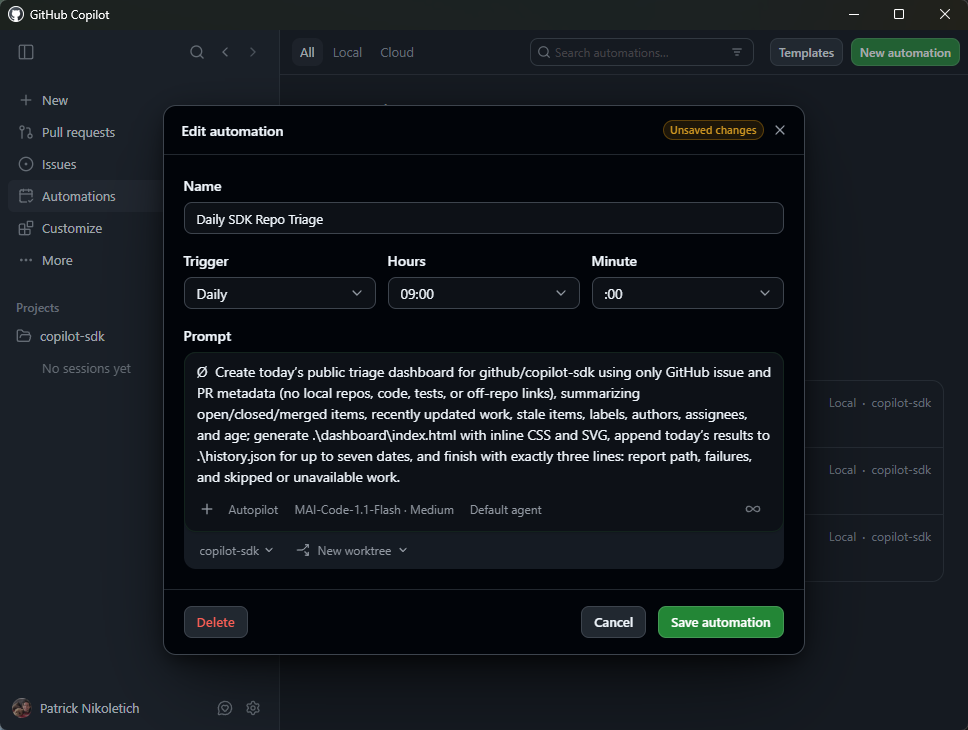
Pagkatapos magtakda ng malinaw na pamagat at oras ng pag-trigger na 9AM araw-araw, i-paste ang mga pangunahing tagubilin para gabayan ang ahente sa paggawa ng pang-araw-araw na dashboard para sa pagsubok.
Create today’s public triage dashboard for github/copilot-sdk using only GitHub issue and PR metadata (no local repos, code, tests, or off-repo links), summarizing open/closed/merged items, recently updated work, stale items, labels, authors, assignees, and age; generate .\dashboard\index.html with inline CSS and SVG, append today’s results to .\history.json for up to seven dates, and finish with exactly three lines: report path, failures, and skipped or unavailable work.
Ang pagpili sa bagong MAI Code 1.1 Flash local model at `copilot-sdk` repo na kung saan kami nag-activate ng sandboxing ay nagbibigay-daan sa ahente na magtrabaho nang off-line gamit ang mga guardrail na makakatulong sa pag-iwas sa mga hindi sinasadyang pagbabago sa iyong lokal na makina—sa lahat habang pinapayagan ang iyong ahente na bumuo at magpatakbo ng mga script sa loob ng kasalukuyang gumaganang direktoryo nito upang subukan at gumawa ng interactive na dashboard.
Pagkatapos i-save, ang pag-click sa `Patakbuhin ito ngayon` ay magsisimulang isagawa kaagad ang bagong automation para sa pag-verify.
Suriin ang resulta
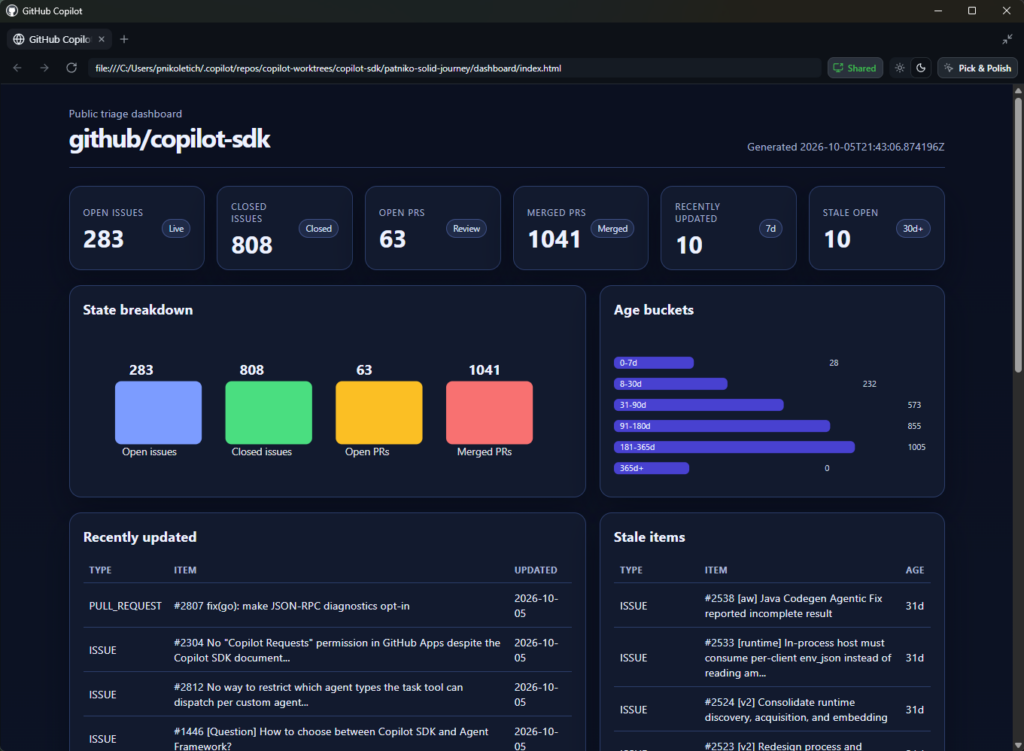
Pagkatapos matapos ng ahente ng GitHub Copilot ang gawain, maaari mong buksan ang mga artifact ng session upang tingnan ang nabuong kopya ng dashboard na mare-refresh araw-araw. Ginagawa ang lahat nang lokal, at may mga sandbox na nagbibigay ng pangunahing proteksyon laban sa mga hindi gustong pagbabago ng system habang bumubuo at nagpapatupad ito ng mga script para magawa ang gawain.
Pagsasara
Ito ay simula pa lamang ng aming paglalakbay. Ang mga lokal na modelo at sandboxed na tool ay inilunsad ngayon upang bigyan ang mga developer ng mas maraming pagpipilian kung saan tumatakbo ang intelligence at mas malinaw na kontrol sa kung ano ang magagawa ng mga ahente. Magsimula sa lokal na pag-unlad gamit ang GitHub Copilot.
Mga Pasasalamat
PM: Ryan Hecht, Tucker Burns, Lei Xu, Pierce Boggan, Nhu Do, Greg Woo, Ramya Krishna Akula, Demetrius Nelon, Harald Kirschner
Engineering: Andrew Feller, Devraj Mehta, Mackinnon Buck, Roman Bulanenko, Chris Dern, Daniel Pagan, Keith Mahoney, Vicente Rivera, Austin Hodges, Anis Mohammed Khaja Mohideen, Stuart Schaefer, Sha Viswanathan, Carlos Alexandro Becker, Logan Ramos
Agham: Ani Balasubramaniam, Shengyu Fu, Aashna Garg, Aakash Goel, Karthik Vijayan, Jennifer Zhu, Vivek Pradeep
Marketing: Katie Liu, Alyanna Castillo
Ang listahang ito ay hindi komprehensibo ng lahat ng taong nagtrabaho sa proyektong ito. Espesyal na salamat sa pangkat na nagsama-sama nito.